Benchmark run
Codictate's main models at 400 recordings per language
Whisper Small, Large V3 Turbo, Large V3 and Parakeet TDT 0.6B v3 on 400 recordings per language, the depth of the first Wispr Flow comparison. M4 Max.
Sep 4, 2026
Run note: Curated models at 400 samples per dataset to match the Wispr Flow 1.6.765 external-product run at equal depth for the published comparison
- Models
- 4
- Samples per dataset
- 400
- Warmup runs
- 3
- Hardware
- Apple M4 Max / 36 GB / macOS 26.6.2
Full results
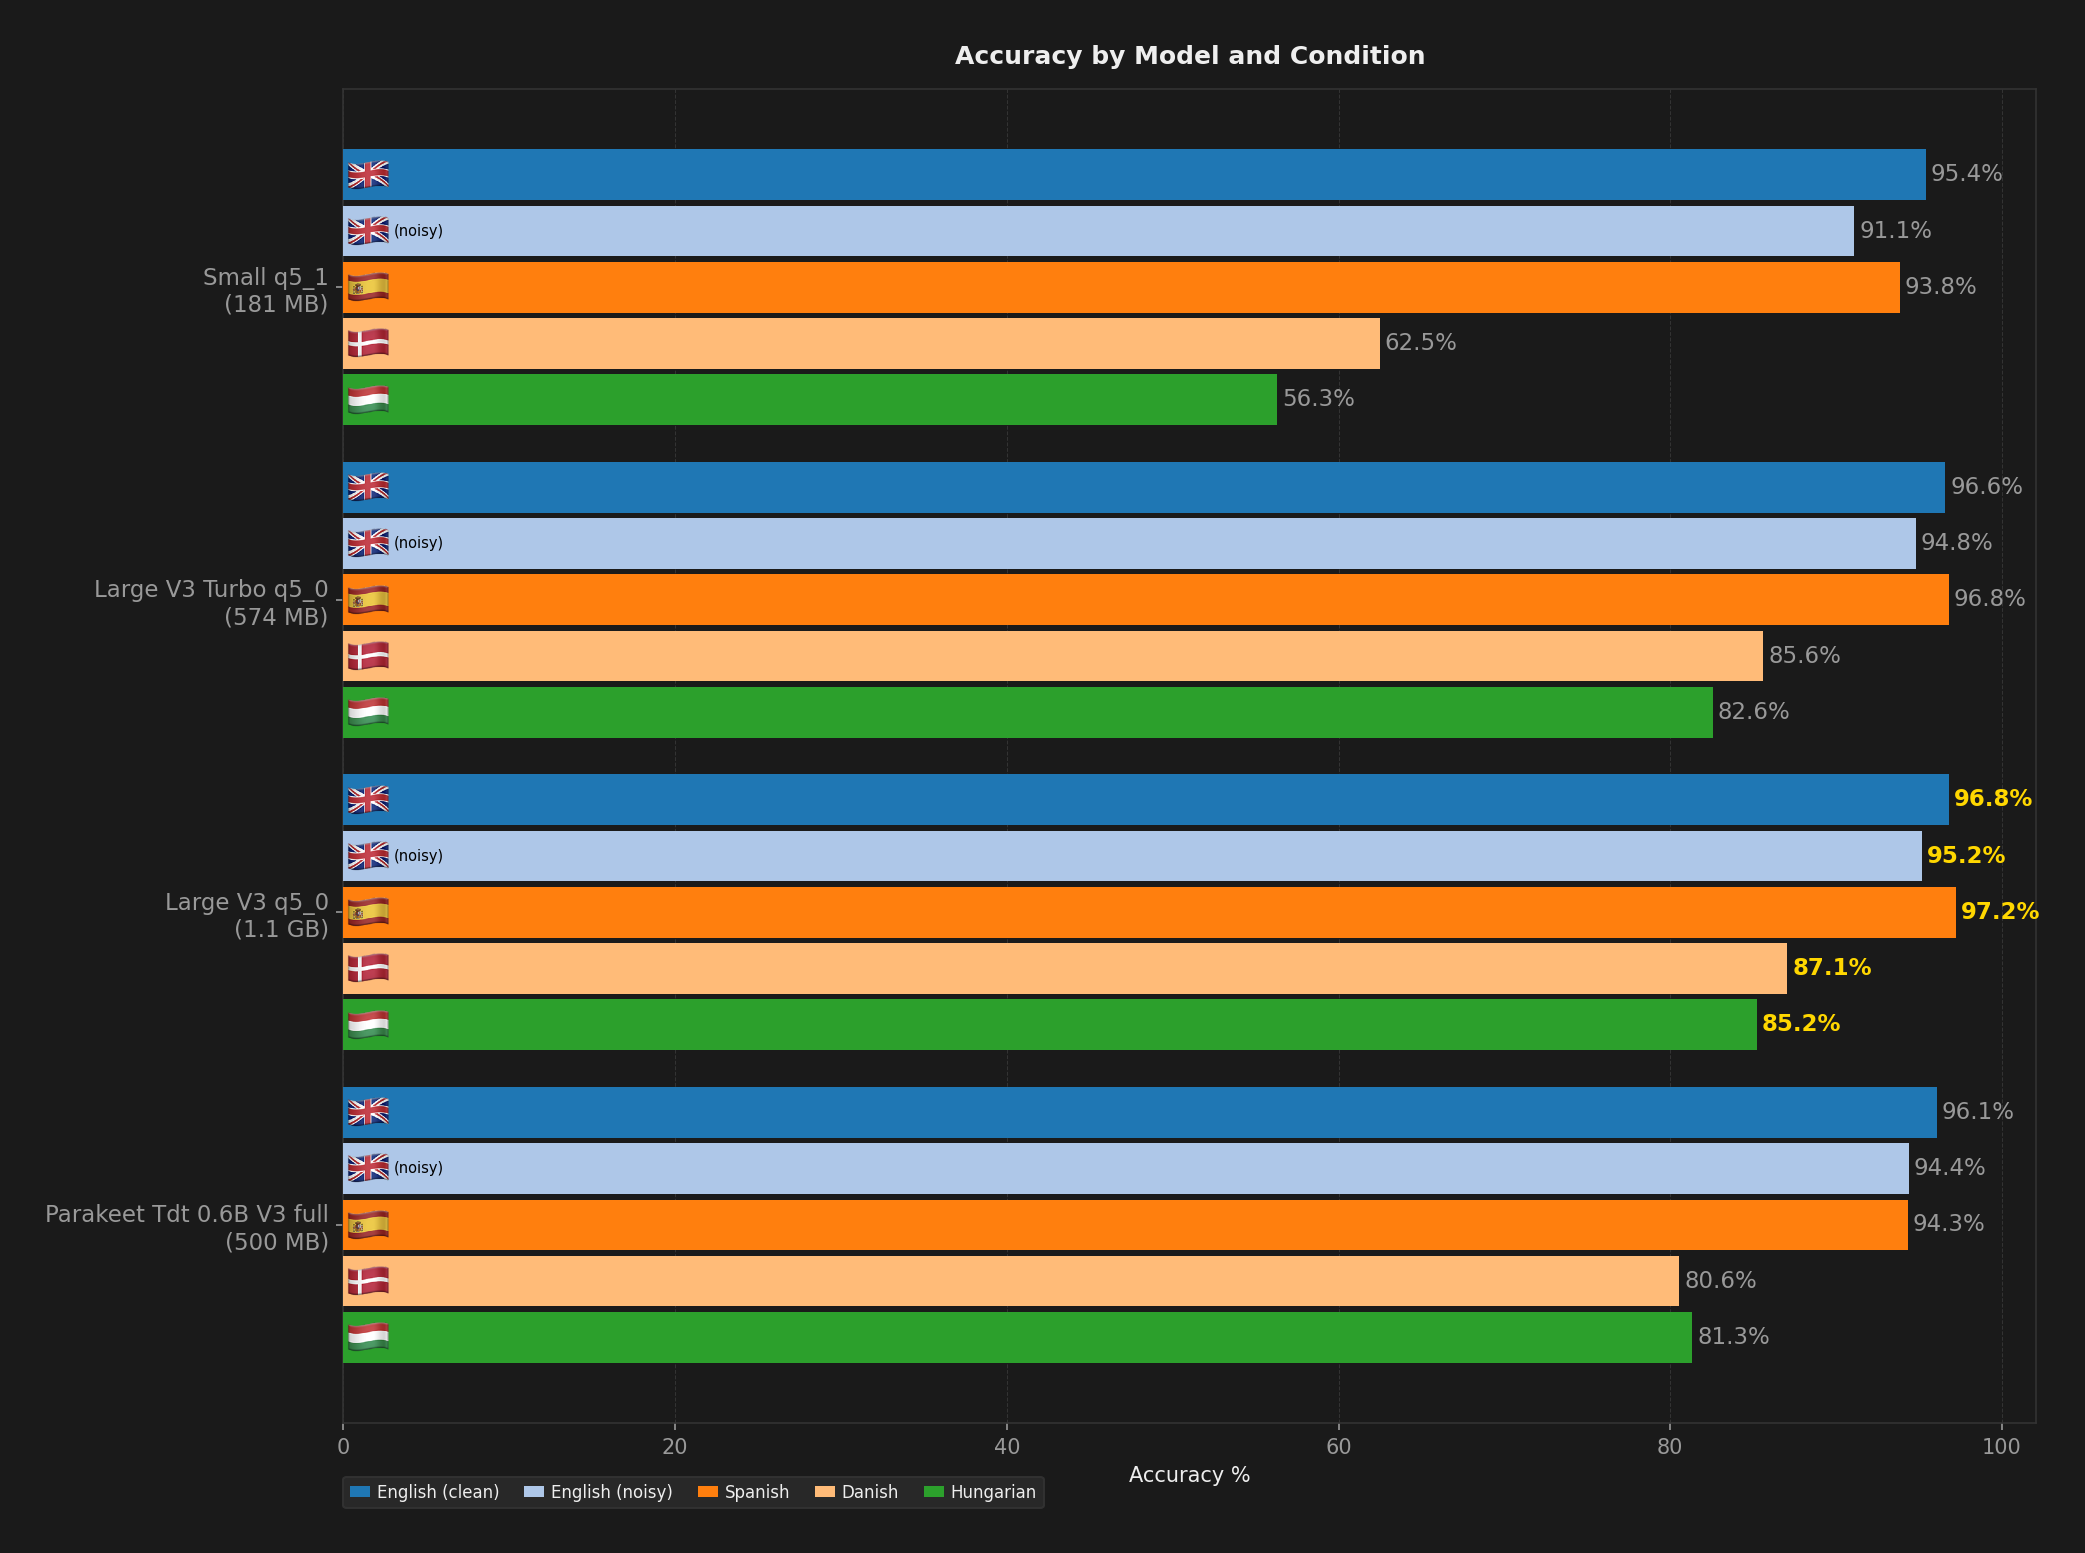
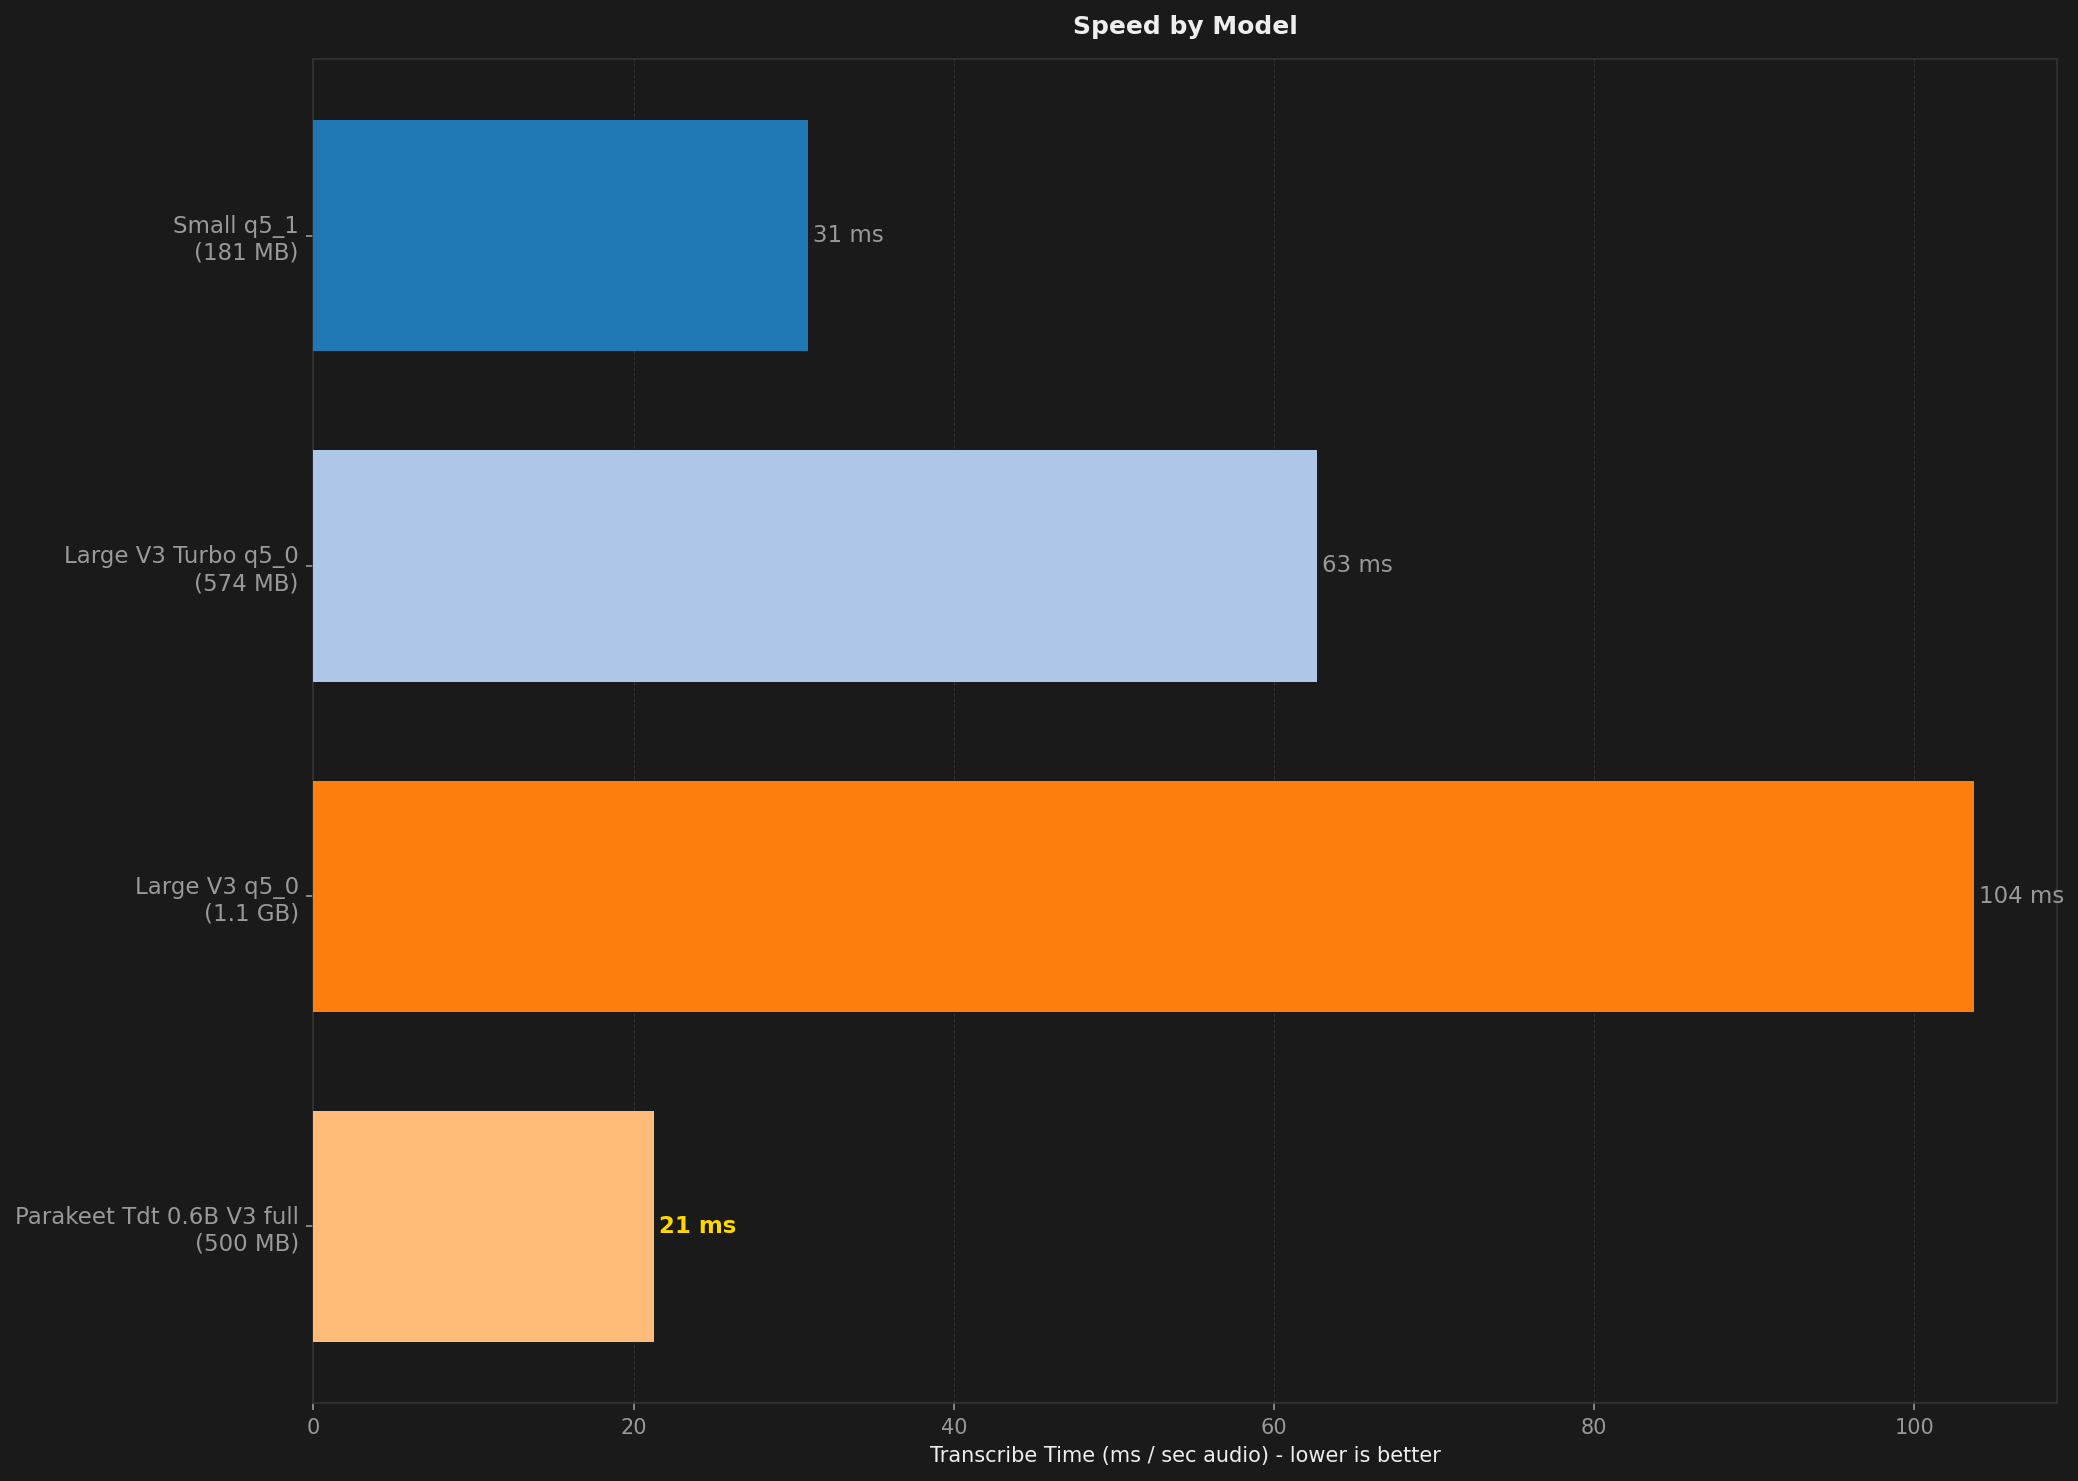
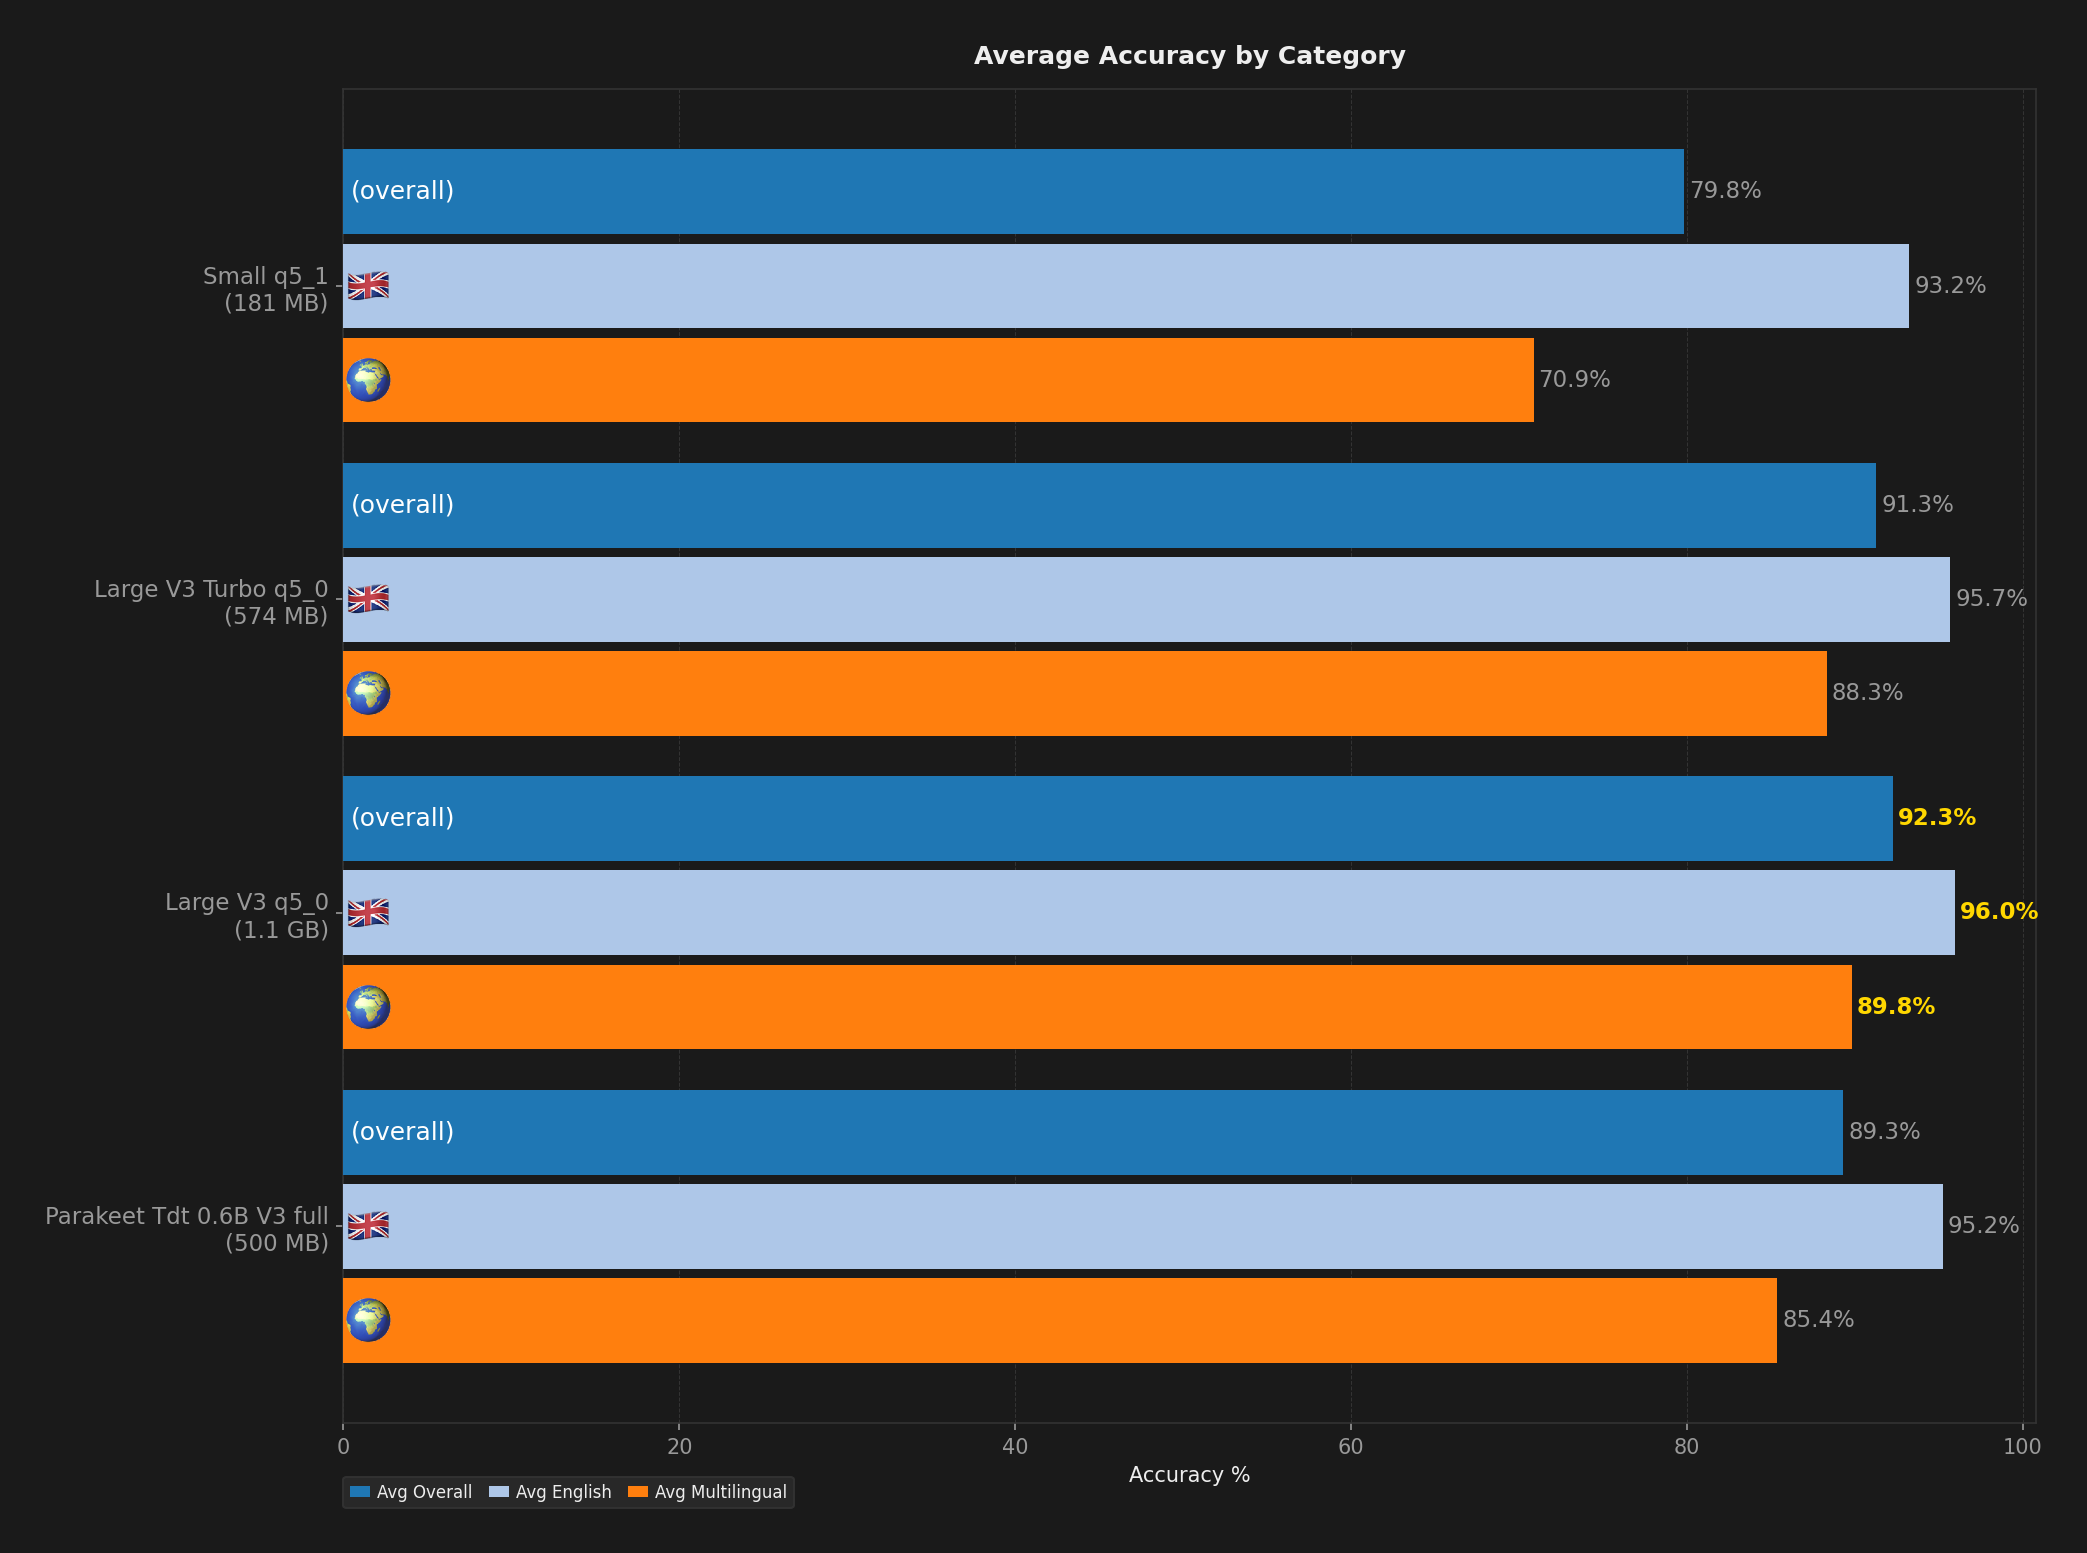
Accuracy is the share of words transcribed correctly per language condition, so higher is better; speed is milliseconds per second of audio, so lower is better. The best value in each column is emphasised, and a cell reading a dash says on hover why there is no figure in it.
Accuracy (%) per language, and speed in ms per second of audio, so lower is better. A cell reading a dash was never measured, and hovering any cell says what is behind it.
| Whisper Large V3 Q5_0 | 397 | 1.1 GB | 1.5 GB | 99 ms | 92.6%Every word from every language counted together, not an average of per-language scores. | 96.0%Every word from every language counted together, not an average of per-language scores. | 90.6%Every word from every language counted together, not an average of per-language scores. | 96.8% | 95.2% | 97.2% | 87.1% | 85.2% |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Whisper Large V3 Turbo Q5_0 | 397 | 574 MB | 757 MB | 59 ms | 91.6%Every word from every language counted together, not an average of per-language scores. | 95.7%Every word from every language counted together, not an average of per-language scores. | 89.2%Every word from every language counted together, not an average of per-language scores. | 96.6% | 94.8% | 96.8% | 85.6% | 82.6% |
| Parakeet TDT 0.6B v3 | 397 | 500 MB | 80 MB | 20 ms | 89.6%Every word from every language counted together, not an average of per-language scores. | 95.3%Every word from every language counted together, not an average of per-language scores. | 86.2%Every word from every language counted together, not an average of per-language scores. | 96.1% | 94.4% | 94.3% | 80.6% | 81.3% |
| Whisper Small Q5_1 | 397 | 181 MB | 383 MB | 30 ms | 80.7%Every word from every language counted together, not an average of per-language scores. | 93.3%Every word from every language counted together, not an average of per-language scores. | 73.2%Every word from every language counted together, not an average of per-language scores. | 95.4% | 91.1% | 93.8% | 62.5% | 56.3% |
At a glance
Ratings computed from benchmark data, scaled 1 to 10, and written with their scale in every cell. Accuracy is based on Word Error Rate (WER) and does not include punctuation yet.
Ratings run 1 to 10, higher is better. A cell reading a dash was never measured, and hovering any cell says what is behind it.
| Whisper Large V3 Q5_0 | All languages | Yes | 7/10 | 10/10Every word from every language counted together, not an average of per-language scores. |
|---|---|---|---|---|
| Whisper Large V3 Turbo Q5_0 | All languages | No | 8/10 | 9/10Every word from every language counted together, not an average of per-language scores. |
| Parakeet TDT 0.6B v3 | 25 languages | No | 9/10 | 9/10Every word from every language counted together, not an average of per-language scores. |
| Whisper Small Q5_1 | All languages | Yes | 9/10 | 7/10Every word from every language counted together, not an average of per-language scores. |
Charts
The plots generated alongside this run. Select a chart to open it full size.