Benchmark run
Main model comparison
Comparison of Codictate's curated speech models (Small q5_1, Large V3 Turbo q5_0, Large V3 q5_0, Parakeet) to determine the best-performing default model.
May 8, 2026
- Models
- 4
- Samples per dataset
- 200
- Warmup runs
- 3
- Hardware
- Apple M4 Max / 36 GB / macOS 26.4.1
Full results
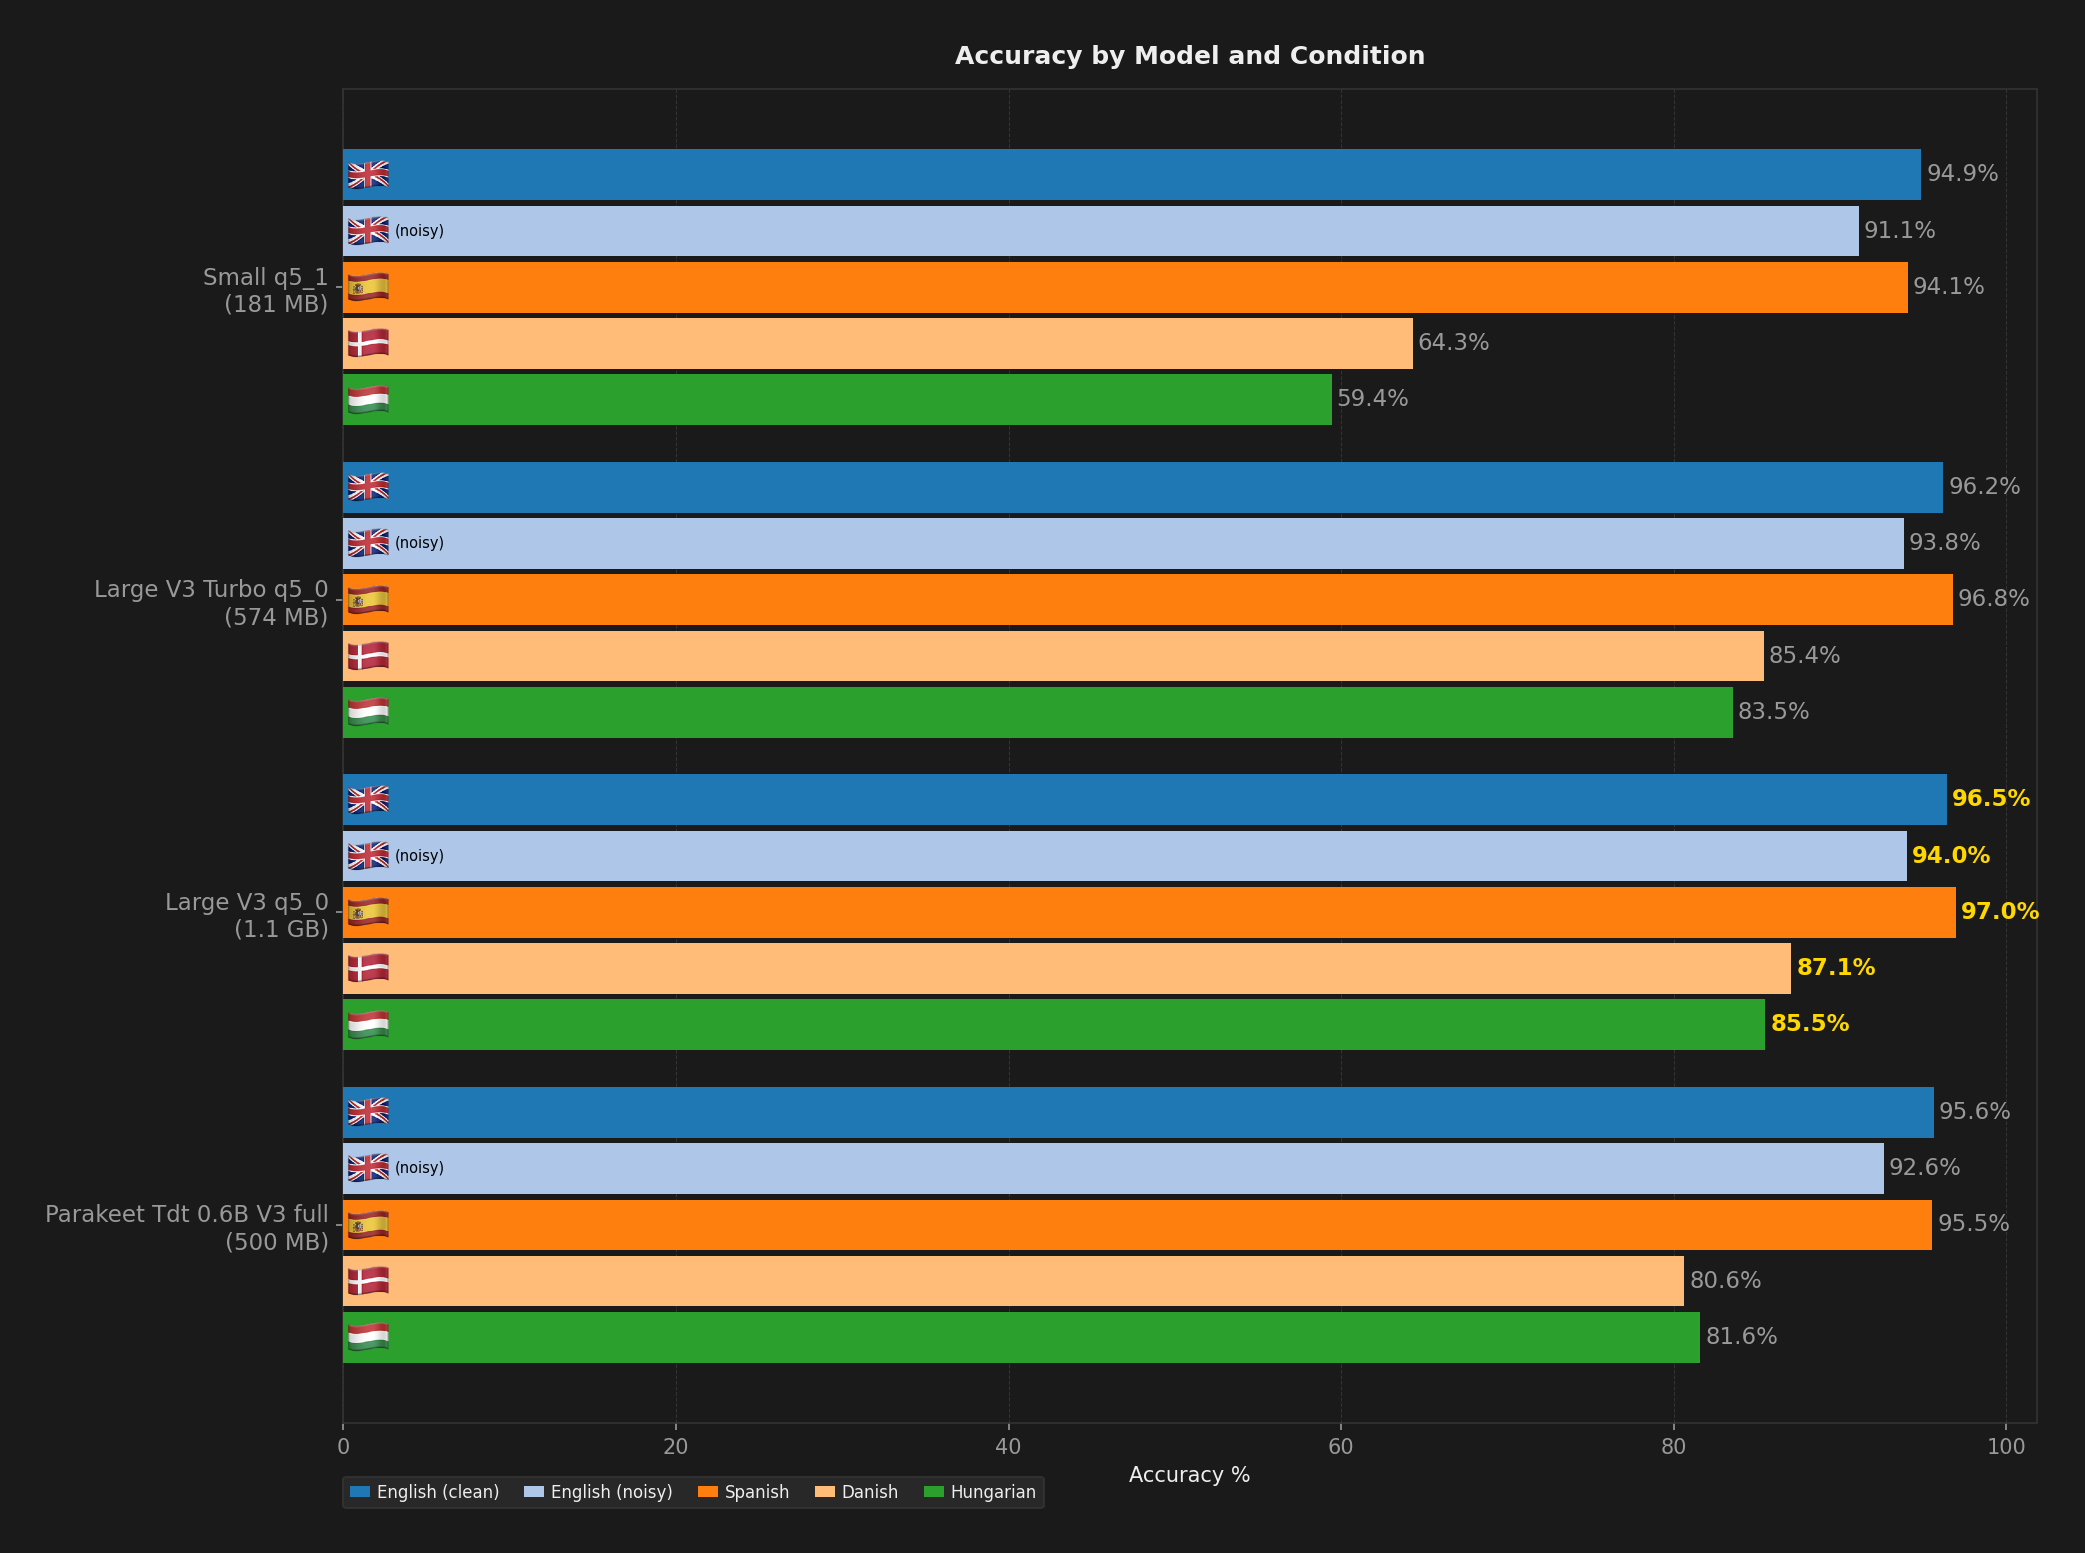
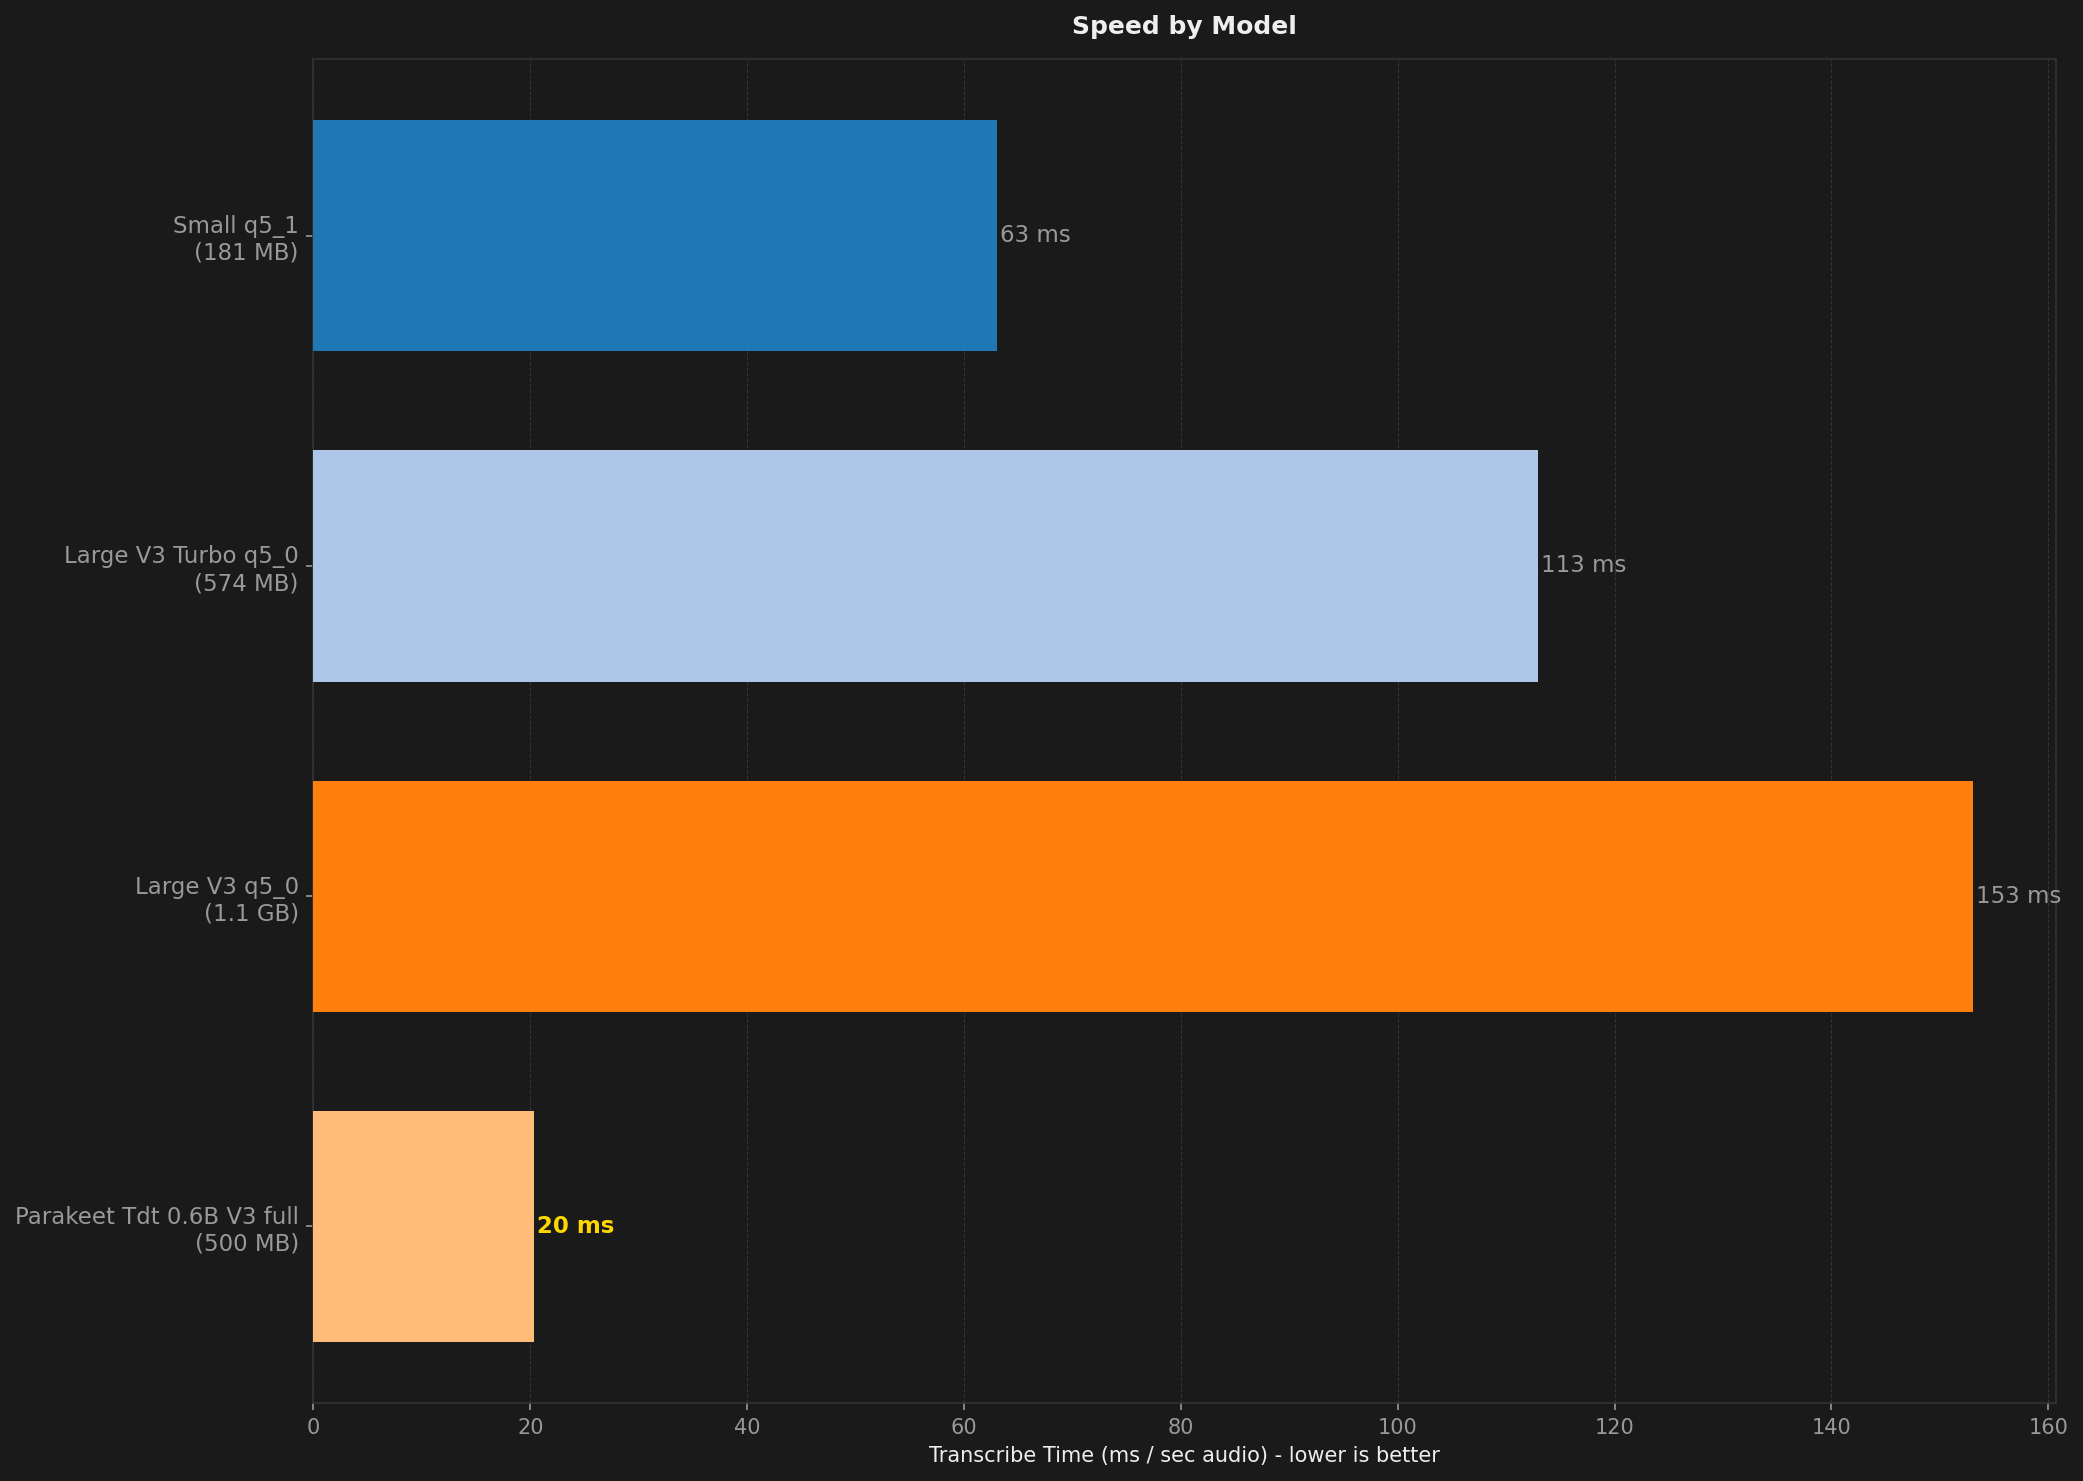
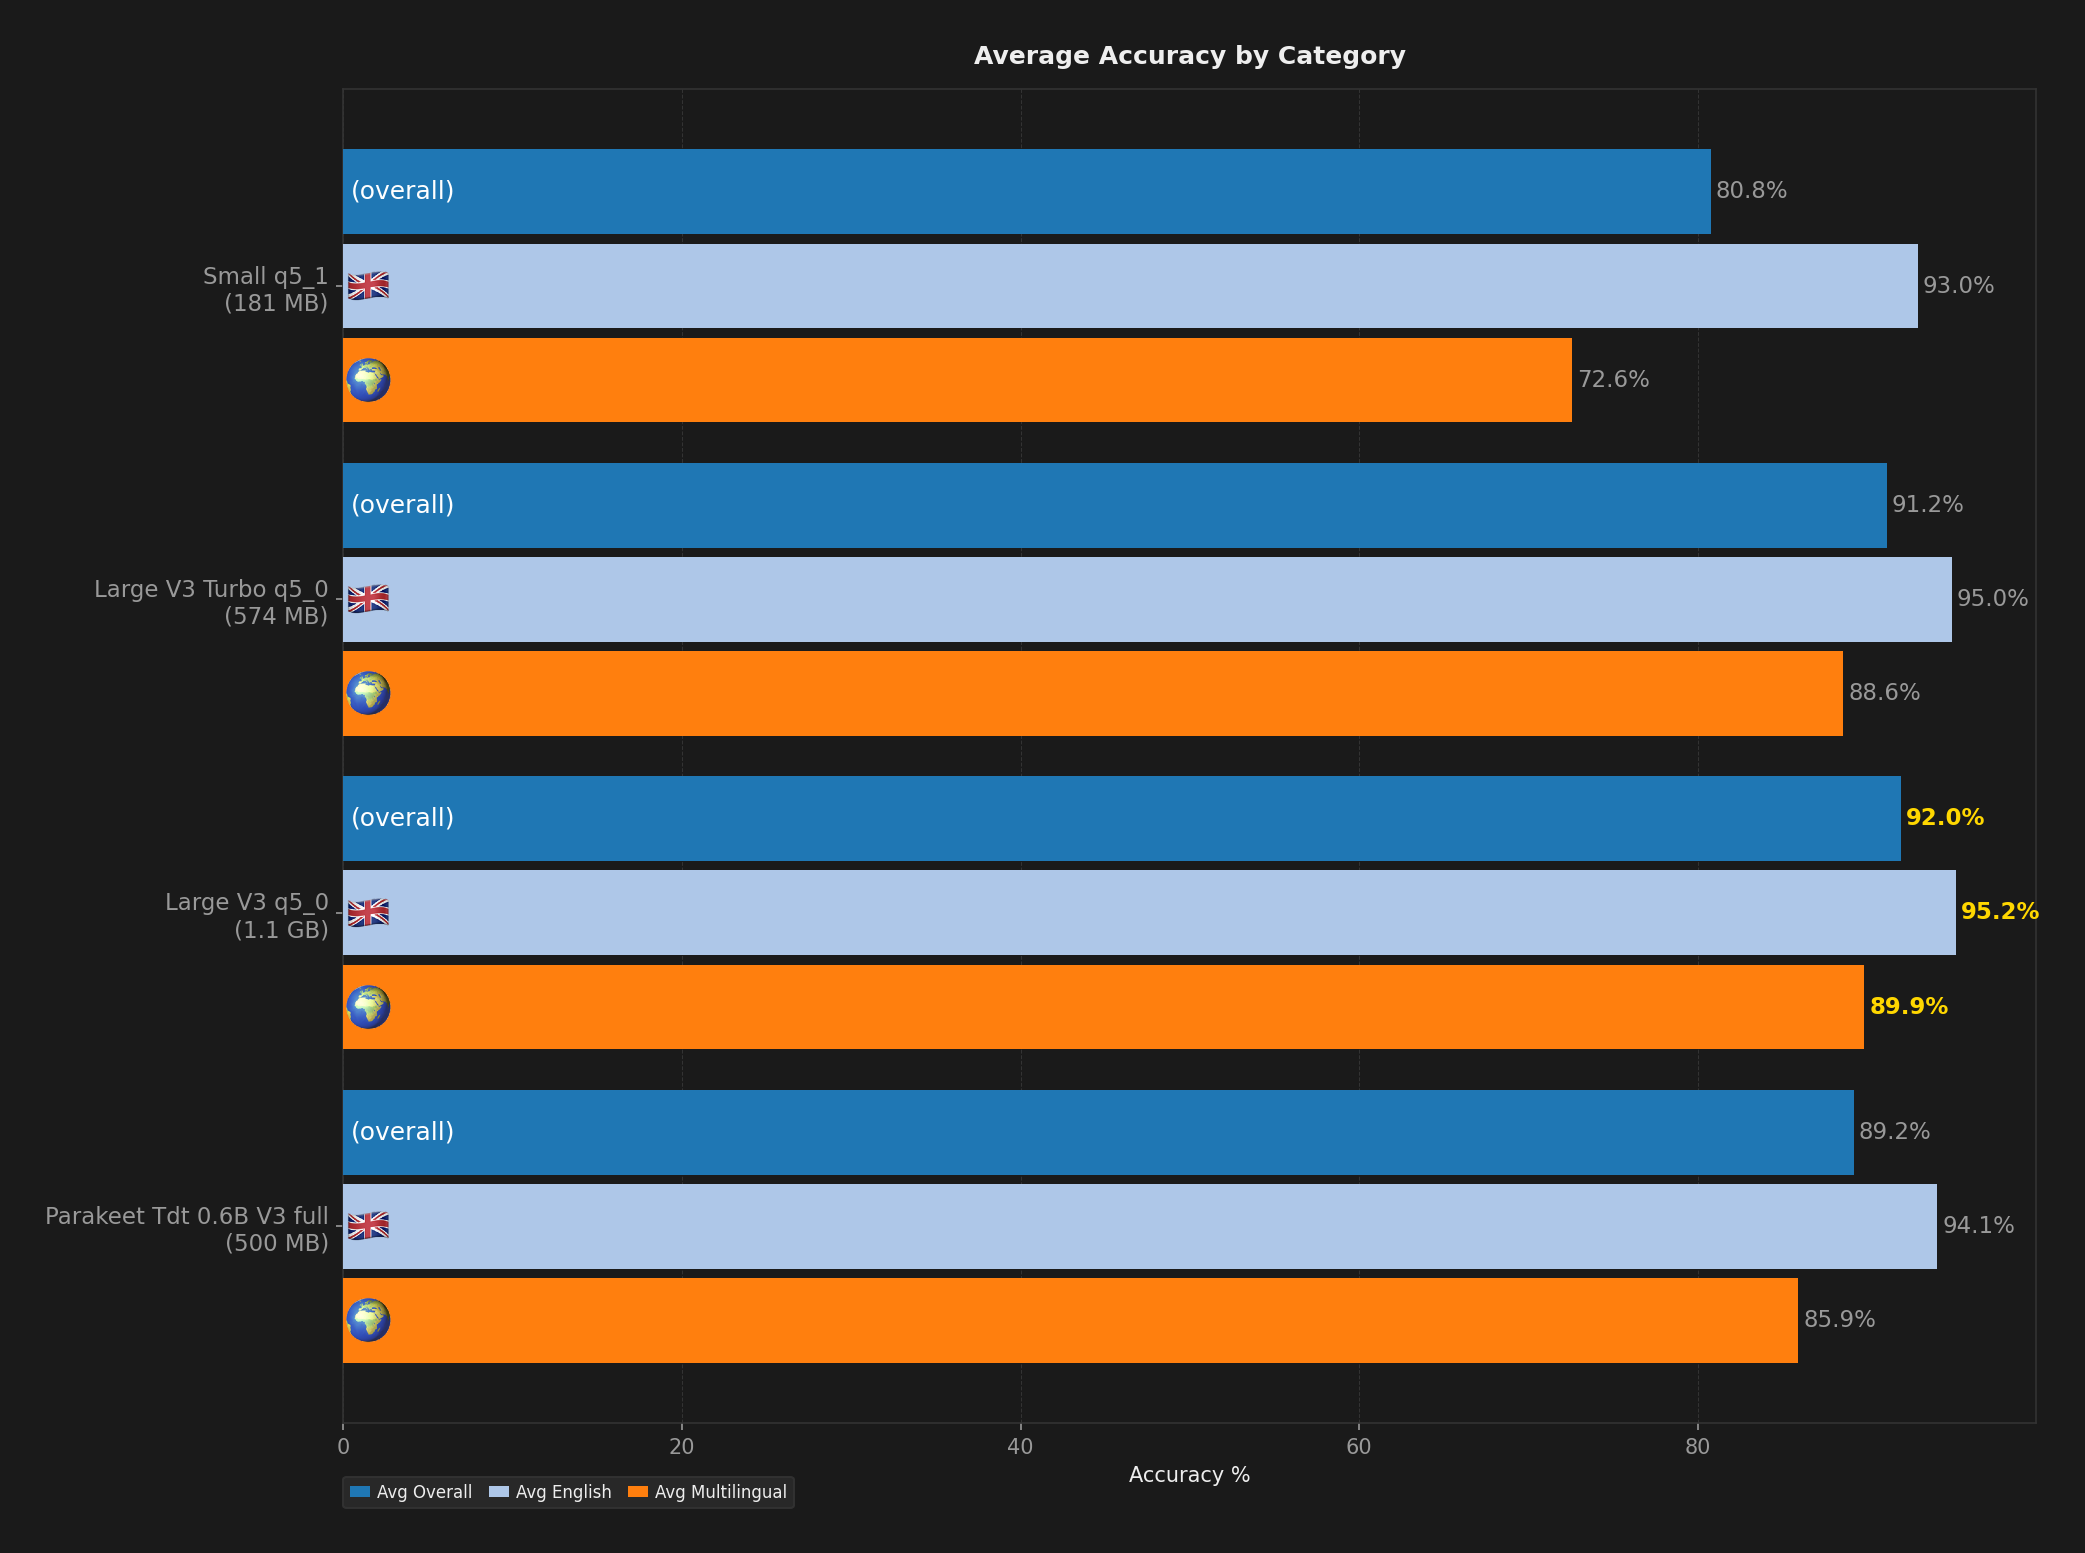
Accuracy is the share of words transcribed correctly per language condition, so higher is better; speed is milliseconds per second of audio, so lower is better. The best value in each column is emphasised, and a cell reading a dash says on hover why there is no figure in it.
Accuracy (%) per language, and speed in ms per second of audio, so lower is better. A cell reading a dash was never measured, and hovering any cell says what is behind it.
| Whisper Large V3 Q5_0 | 197 | 1.1 GB | 2.0 GB | 147 ms | 92.2%Every word from every language counted together, not an average of per-language scores. | 95.3%Every word from every language counted together, not an average of per-language scores. | 90.4%Every word from every language counted together, not an average of per-language scores. | 96.5% | 94.0% | 97.0% | 87.1% | 85.5% |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Whisper Large V3 Turbo Q5_0 | 197 | 574 MB | 801 MB | 105 ms | 91.3%Every word from every language counted together, not an average of per-language scores. | 95.0%Every word from every language counted together, not an average of per-language scores. | 89.3%Every word from every language counted together, not an average of per-language scores. | 96.2% | 93.8% | 96.8% | 85.4% | 83.5% |
| Parakeet TDT 0.6B v3 | 197 | 500 MB | 80 MB | 19 ms | 89.4%Every word from every language counted together, not an average of per-language scores. | 94.2%Every word from every language counted together, not an average of per-language scores. | 86.7%Every word from every language counted together, not an average of per-language scores. | 95.6% | 92.6% | 95.5% | 80.6% | 81.6% |
| Whisper Small Q5_1 | 197 | 181 MB | 477 MB | 58 ms | 81.1%Every word from every language counted together, not an average of per-language scores. | 93.0%Every word from every language counted together, not an average of per-language scores. | 74.4%Every word from every language counted together, not an average of per-language scores. | 94.9% | 91.1% | 94.1% | 64.3% | 59.4% |
At a glance
Ratings computed from benchmark data, scaled 1 to 10, and written with their scale in every cell. Accuracy is based on Word Error Rate (WER) and does not include punctuation yet.
Ratings run 1 to 10, higher is better. A cell reading a dash was never measured, and hovering any cell says what is behind it.
| Whisper Large V3 Turbo Q5_0 | All languages | No | 7/10 | 9/10Every word from every language counted together, not an average of per-language scores. |
|---|---|---|---|---|
| Whisper Large V3 Q5_0 | All languages | Yes | 6/10 | 9/10Every word from every language counted together, not an average of per-language scores. |
| Parakeet TDT 0.6B v3 | 25 languages | No | 10/10 | 9/10Every word from every language counted together, not an average of per-language scores. |
| Whisper Small Q5_1 | All languages | Yes | 9/10 | 7/10Every word from every language counted together, not an average of per-language scores. |
Charts
The plots generated alongside this run. Select a chart to open it full size.